位图和布隆过滤器

目录
位图
位图的实现
布隆过滤器
布隆过滤器代码
位图
先看这样一个面试题:
给40亿个不重复的无符号整数,没排过序。给一个无符号整数,如何快速判断一个数是否在这40亿个数中。【腾讯】
- 1. 遍历,时间复杂度O(N)
时间和空间复杂度都过高,实现起来效率太差
- 2. 排序(O(NlogN)),利用二分查找: logN
虽然查找效率还可以,但将数据存起来并进行排序很消耗时间和空间
- 3. 位图解决
数据是否在给定的整形数据中,结果是在或者不在,刚好是两种状态,那么可以使用一个二进制比特位来代表数据是否存在的信息,如果二进制比特位为1,代表存在,为0代表不存在,这种方式叫位图。
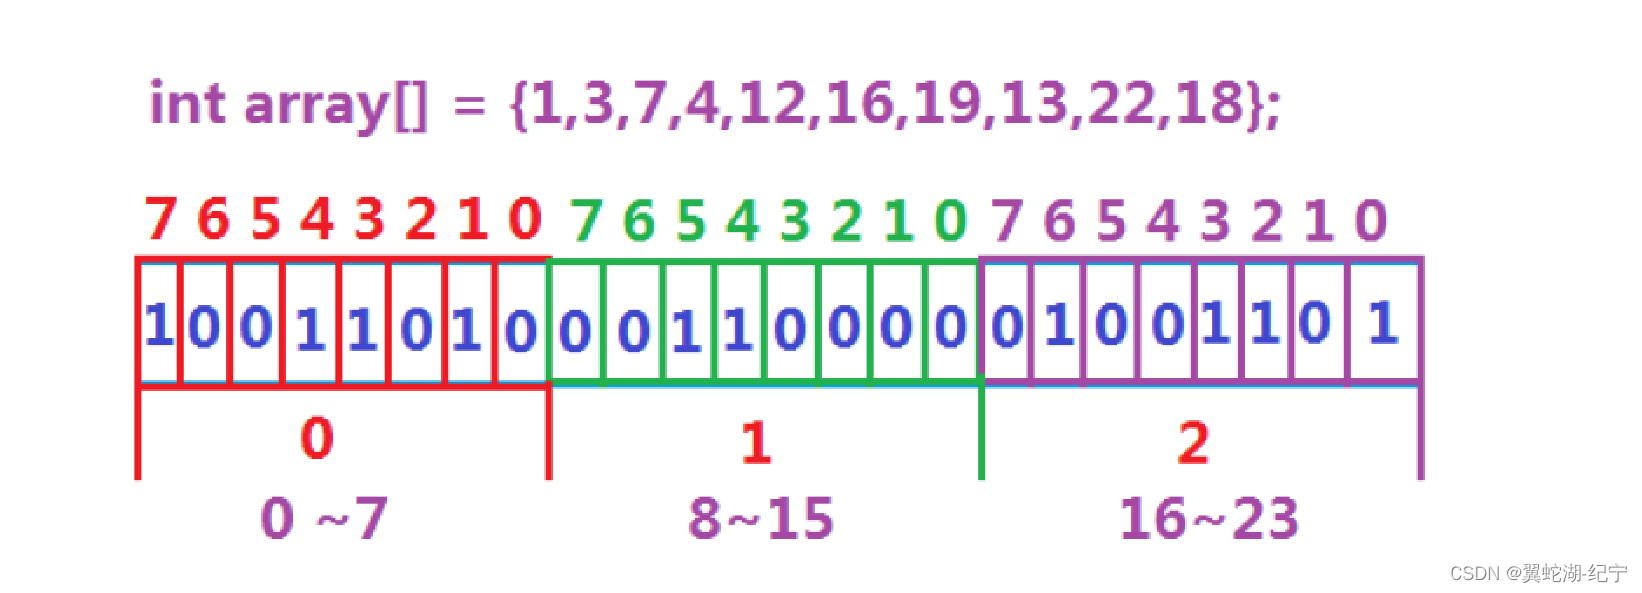
例如要存储 N 个数据,并判断0~N 中某个数是否存在于给定的数据当中,一共开 N 个比特位数组的空间,遍历需要判断的数据群,0~N 中哪个数 n 存在,就将数组第 n 个下标对应的值置为 1,在查找数据 n 的时候,只需要判断下标 n 位置存储的值是否为 1 即可。
如下图,将这些数据存入位图:
位图的实现
- 1、将数据存入位图
在计算机中,比特是最小的存储单位,而计算机中处理数据的基本单位却是字节,所以需要在以字节为单位的数组中进行定位,找到这个数据对应的比特位在顺序上属于哪一字节,并将这个字节的对应比特位改为1(1字节等于 8 比特,那么一个整形就是 32 比特)
对应比特位的计算方法:找到这个数据属于第几个整形的范畴,一个整形是32个比特位。例如,0就属于第一个int 的范畴,36就属于第二个整形的范畴,64 就属于第二个整形的范畴(0~31 32~63 64~95)以此类推。那么 36 就属于第二个整形的第 5 个比特位,64就属于第三个整形的第 1 个比特位。
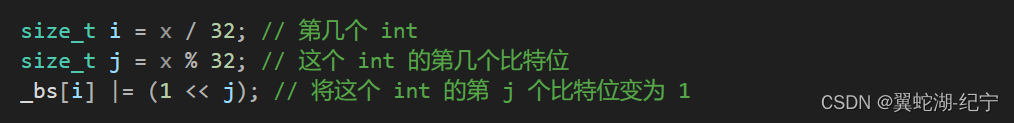
假设需要将 x 写入位图(位图的空间开的足够大),那么 x / 32 就能得到 x 属于第几个 int 的范畴,x % 32就能得到 x 是这个 int 的第几个比特位。
再根据上面的计算结果,进行位运算就能将对应位置的比特位变为 1。
- 2、将数据从位图中删除
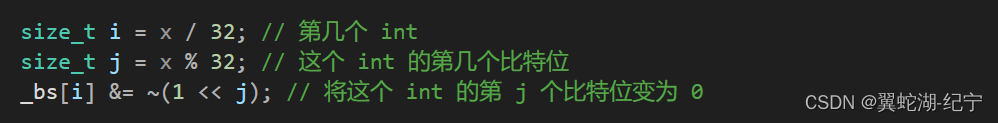
和前面的方式一样,先计算出对应的 i 和 j,然后进行位运算,将对应位置的比特位变为0
- 3、检测数据是否在位图中
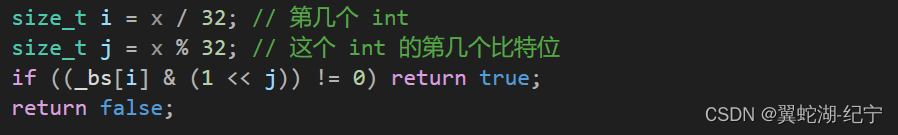
先算出如果这个数据在位图中,它的具体位置,然后进行按位与运算,保证只有那个位置为1,其余位置为0。如果计算结果不为 0 的话,就说明这个在位图中为1,那么这个数据就在位图中!
- 4、测试位图
参数 800 需要传的是需要检测数据中的最大值
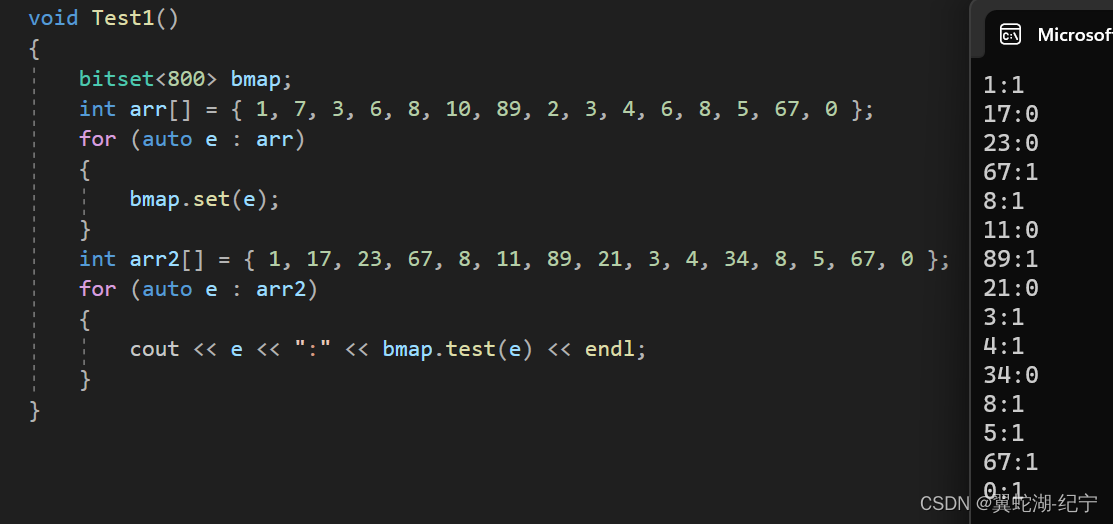
回到前面腾讯的面试题,需要在40多亿数字中,检测一个数在不在,那么只需要传参数的时候传 0xffffffff 或者 -1即可,然后需要判断哪一个数在不在,直接判断即可,判断的时间复杂度为O(1),但要开 40 多亿个比特大小的数据,大概还需要 0.5G 的空间。
- 代码实现
#include<vector>
#include<iostream>
using namespace std;
namespace zyb
{template<size_t N>class bitset{public:bitset(){_bs.resize(N / 32 + 1);}void set(const size_t& x){size_t i = x / 32; // 第几个 intsize_t j = x % 32; // 这个 int 的第几个比特位_bs[i] |= (1 << j); // 将这个 int 的第 j 个比特位变为 1}void reset(const size_t& x){size_t i = x / 32; // 第几个 intsize_t j = x % 32; // 这个 int 的第几个比特位_bs[i] &= ~(1 << j); // 将这个 int 的第 j 个比特位变为 0}bool test(const size_t& x){size_t i = x / 32; // 第几个 intsize_t j = x % 32; // 这个 int 的第几个比特位if ((_bs[i] & (1 << j)) != 0) return true;return false;}private:vector<int> _bs;};
}
布隆过滤器
布隆过滤器是由布隆(Burton Howard Bloom)在1970年提出的 一种紧凑型的、比较巧妙的概率型数据结构,特点是高效地插入和查询,可以用来告诉你 “某样东西一定不存在或者可能存在”,它是用多个哈希函数,将一个数据映射到位图结构中。此种方式不仅可以提升查询效率,也可以节省大量的内存空间。
非整形的数据转化为整形,无论利用何种方式,都有可能会发生冲突的情况,发生冲突,在检测时就有可能会发生错误,这时候为了减小这种冲突带来的错误,就需要使用布隆过滤器。
布隆过滤器适用于非整形的数据,用多个哈希函数计算出多个整形值,统统映射到位图中,这样相当于一个数据在位图中就对应多个位置。当检测一个数据是否存在时,利用这几个哈希函数计算出对应于位图中的比特位位置,只有查看这些比特位都为1时,才算是这个数据存在,只要有一个位置不符合,就不存在!
布隆过滤器代码
它的实现是基于位图的。
struct BKDRHash{size_t operator()(const string& s){// BKDRsize_t value = 0;for (auto ch : s){value *= 31;value += ch;}if(value > 0xffffffff) value %= 0xffffffff;return value;}};struct APHash{size_t operator()(const string& s){size_t hash = 0;for (long i = 0; i < s.size(); i++){if ((i & 1) == 0){hash ^= ((hash << 7) ^ s[i] ^ (hash >> 3));}else{hash ^= (~((hash << 11) ^ s[i] ^ (hash >> 5)));}}if(hash > 0xffffffff) hash %= 0xffffffff;return hash;}};struct DJBHash{size_t operator()(const string& s){size_t hash = 5381;for (auto ch : s){hash += (hash << 5) + ch;}if (hash > 0xffffffff) hash %= 0xffffffff;return hash;}};template<size_t N,class K= string, class Hash1 = BKDRHash,class Hash2 = APHash,class Hash3 = DJBHash>class bloomfilter{public:void set(const K& key){size_t i = BKDRHash()(key);size_t j = APHash()(key);size_t k = DJBHash()(key);_biset.set(i);_biset.set(j);_biset.set(k);}bool test(const K& key){size_t i = BKDRHash()(key);size_t j = APHash()(key);size_t k = DJBHash()(key);if (_biset.test(i) && _biset.test(j) && _biset.test(k)) return true;else return false;}private:bitset<N> _biset;};