0125-2-Vue深入学习1—mustache模板引擎原理

[mustache] 是 “胡子”的意思,因为它的嵌入标记 {{ }} 旋转过来很像[胡子],Vue中的 {{ }} 语法也引用了mustache,这也是我深入学习的目的。
1、原始js方式使 数据 变为视图
 <ul id="list"></ul><script>var arr = [{"name":"张三", "age":12, "sex":"男"},{"name":"李四", "age":13, "sex":"女"},{"name":"王五", "age":14, "sex":"女"},{"name":"赵六", "age":15, "sex":"男"},]var list = document.getElementById('list');// jion法——遍历arr数组,每遍历一项,就将HTML 字符串添加到list 中for(let i = 0; i<arr.length; i++){list.innerHTML += ['<li>','    <div class="hd">'+ arr[i].name +'</div>','    <div class="bd">','        <p>姓名:'+ arr[i].name +'</p>','        <p>年龄:'+ arr[i].age +'</p>','        <p>性别:'+ arr[i].sex +'</p>','    </div>','</li>'].join('')}// 反引号法——遍历arr数组,每遍历一项,就将HTML 字符串添加到list 中for(let i = 0; i<arr.length; i++){list.innerHTML += `<li><div class="hd"> ${arr[i].name} </div><div class="bd"><p>姓名:${arr[i].name}</p><p>年龄:${arr[i].age }</p><p>性别:${arr[i].sex }</p></div</li>`;}
</script>
2、mustache的底层原理
要实现这样的:

<script// 模板var templateStr =  '<h1>今天我买了一辆{{thing}},{{money}}W,很{{mood}}</h1>';// 数据var data = {thing: '兰博基尼',money: 50,mood: '开心'};// 1.使用正则实现简单数据填充,正则中的 g 表示全局,把'你'替换成 '我'// console.log('你很帅,你很有钱'.replace(/你/g,'我'));// 2.最简单的模板引擎实现机理,利用正则表达式中的replace()方法//   replace()的第二个参数$1 可以是一个函数,这个喊啊书提供的东西的参数就是$1function render(templateStr, data){return templateStr.replace(/\{\{(\w+)\}\}/g,function(findStr, $1){return data[$1];});}var result = render(templateStr, data);console.log(result);
</script>
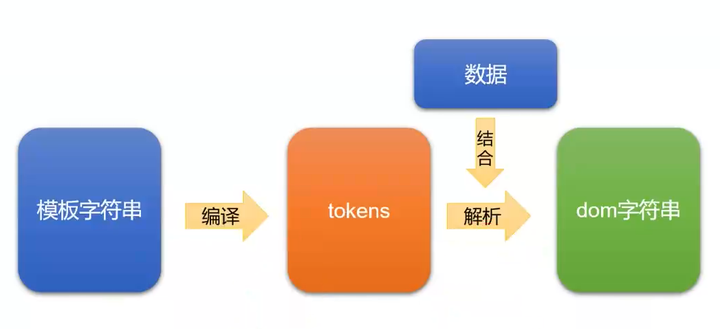
实现方式:Mustache.render(templateStr, data); templateStr模板字符串,data数据,render返回填充后dom字符串。 实现原理:第①步:将模板字符串编译成tokens 形式,第②步:将tokens与数据结合,解析成dom字符串。
2、什么是tokens?
JS的嵌套数组,模板字符串的JS表示形式。
模板字符串:
我买了一辆{{thing}},{{money}}W
tokens:
[["text",  "< h1 >我买了一辆"],["name",  ”thing“],["text",  ","],["name",  ”money“],["text",  "W< /h1 >"],
]
实现tokens思路:用到了《数据结构》中栈的原理,遇到 # 号进栈,遇到 / 线出栈; # 号标记的tokens,需要递归处理它的下标为2的小数组。遍历传入的 tokens 的每一个 token,遇到第一项是 # 和 / 的分别做处理,其余的做一个默认处理。大致思路是当遍历到的 token 的第一项为 # 时,就把直至遇到配套的 / 之前,遍历到的每一个 token 都放入一个容器(collector)中,把这个容器放入当前 token 里作为第 3 项元素。
// nestTokens.js
export default (tokens) => {const nestTokens = []const stack = []let collector = nestTokens // 一开始让收集器 collector 指向最终返回的数组 nestTokenstokens.forEach(token => {switch (token[0]) {case '#':stack.push(token)collector.push(token)collector = token[2] = [] // 连等赋值breakcase '/':stack.pop(token)collector = stack.length > 0 ? stack[stack.length-1][2] : nestTokensbreak;default:collector.push(token)break}})return nestTokens
}