数据结构——哈希表

在C++容器中,map和set是经常被使用的容器,但是,我们会发现。一个是普通的map还有一个是unordered_map,这两者有什么区别呢?那就是map的底层使用的是红黑树而unordered_map底层所使用的是哈希桶,那么今天我们就来认识一下什么是哈希,以及哈希的相关知识,还有哈希表和哈希桶。
1.哈希的简单介绍
我们在做算法题的时候,碰到很多场景都会用到哈希,哈希其实是一种思想。比如这道题:
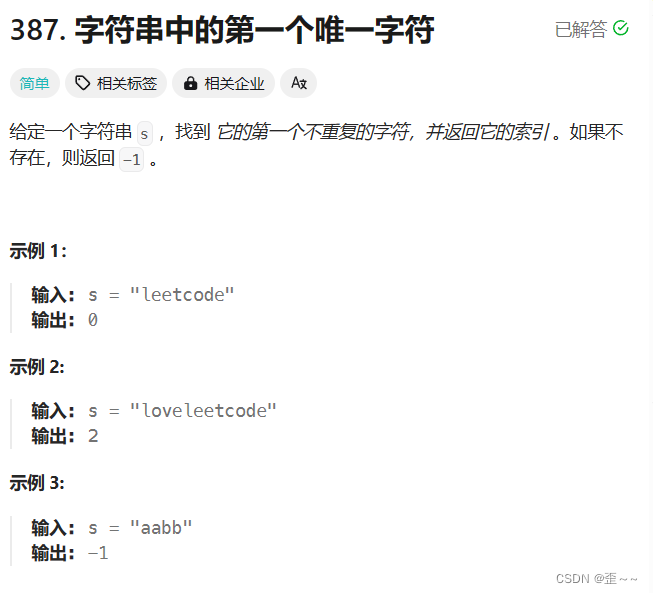
这道题里面我们在学C语言的时候会使用一个数组来记录,这个数组的大小就是二十六个字母,来记录字符串中每个字符出现的个数,这其中我们就使用了哈希的思想,这其中通过让数组的下标与字符产生某种对应关系,让它的某种数据能够被便捷的记录下来。
通过某种函数(hashFunc)使元素的存储位置与它的关键码之间能够建立一一映射的关系,那么在查找时通过该函数可以很快找到该元素该方式即为哈希(散列)方法,哈希方法中使用的转换函数称为哈希(散列)函数,构造出来的结构称为哈希表(Hash Table)(或者称散列表)
很明显,这种方式查找元素和添加元素都是O(1)的时间复杂度,而由红黑树构造的map查找和添加的时间复杂度在O(logN)。这明显要比普通的map更加高效,至于为什么要叫unordered_map,那是因为它跟以红黑树为底层的map有区别,以红黑树为底层的map我们使用中序遍历的key的时候,它的key是按照大小或者用户自定义的大小拍好的有序序列,而以哈希桶为底层的unordered_map它本身是没有升降序属性的。
那我们就先来简单实现一个哈希表:
2. 哈希表的实现
它的一般实现也很简单,就是维护一个数组即可。
a. 前置准备
哈希函数
hashi = key % len
我们所使用的哈希函数也很简单,叫做直接定址法,意思就是将要存储的数据模上数组的长度得到的数字,我们就把他当作键也就是数组的下标来存入数组的该下标中。
哈希表节点
在实现一个哈希表的时候我们要明确一些东西,首先就是哈希表的节点中除了键值对,还要有状态这一属性。
因为我们的哈希表肯定是要有增删查改的基础功能的,那么你删除这一操作体现在数组上是怎样一种情况呢?把他的内存释放吗?又或者是把他改成某一数值?这很明显都是行不通的,哈希表首先他就得能支持随机访问的功能,而改成某种数值的话,更行不通了。所以我们的哈希表中的一个节点应该有以下信息:
enum STATUS{EMPTY,EXIST,DELETE};template<class K, class V>struct HashDate{pair<K, V> _kv;STATUS _s = EMPTY;};
而我们的框架大致是这样:
template<class K, class V>class HashTables{public:HashTables(){_tables.resize(10);}bool insert(const pair<K, V>& kv){}HashDate<K, V>* find(const K& key){}bool erase(const K& key){}private:vector<HashDate<K, V>> _tables;};
哈希冲突
还有一个情况就是我们有点耳熟的哈希冲突了,它其实就是当我们插入哈希表中数据时,我们经过哈希函数运算过后的键的值已经有了数据,这种情况就是哈希冲突,我们有两种比较简单但也常用的方法
1). 线性探测法
hashi += i(i的值随意,一一般是1)
说白了就是如果根据哈希函数运算之后的键的值已经有了数据那我们就一直往后找直到有空位然后在当前空位插入数据,如果到了表的结尾,那就回到表的开头继续寻找,那这时候就会有人说,如果表此时满了怎么办呢?其实哈希表是不会真正“满”的,他会有一个负载因子来控制它的存储量和容量的比例,这个我们稍后再说。
2). 二次探测
hashi += i^2
以上两种方法你选哪种都可以。
负载因子
哈希表中会有负载因子这么一种说法,为的就是不让哈希表是真正满的,这样能够一定程度上减少哈希冲突,因为我们现在知道,过多的哈希冲突会减慢哈希表的效率。所以我们会有负载因子来控制存储量与哈希表容量的的比例:
负载因子 = 存储关键字个数/空间大小
负载因子的比例一般是在0.7,这样既不会过多的浪费空间,也会一定程度上比较好的减少哈希冲突。
所以我们现在框架应该是这样:
template<class K, class V, class Hash = Hash<K>>class HashTables{public:HashTables(){_tables.resize(10);}bool insert(const pair<K, V>& kv){}HashDate<K, V>* find(const K& key){}bool erase(const K& key){}private:vector<HashDate<K, V>> _tables;size_t _n = 0;};
b. 实现
首先实现的就是插入方法
我们实现插入方法的时候需要注意一点:
在直接定址法的情况下,扩容的时候键与值的关系要发生变化,不然就不能通过键
来找到对应的值了。因为len发生了变化。
这个扩容我们可以这样写:
if (_n * 10 / _tables.size() >= 7){vector<HashDate<K, V>> newtables;newtables.resize(_tables.size() * 2);for (auto& v : _tables){if (v._s == EXIST){size_t hashi = v.first % newtables.size();while (newtables[hashi]._s == EXIST) hashi++, hashi %= newtables.size();newtables[hashi]._kv = kv;newtables[hashi]._s = EXIST;}}swap(newtables, _tables);}
以上代码是可行的,但是当我们写出插入数据的逻辑时发现,插入数据的逻辑和更换新表的逻辑好像差不多,所以就有了更优秀的写法:
bool insert(const pair<K, V>& kv){if (find(kv.first) != nullptr) return false;if (_n * 10 / _tables.size() >= 7){HashTables<K, V> tmp;tmp._tables.resize(_tables.size() * 2);for (auto& v : _tables){if (v._s == EXIST)tmp.insert(v._kv);}swap(tmp._tables, _tables);}size_t hashi = kv.first % _tables.size();while (_tables[hashi]._s == EXIST) hashi++, hashi %= _tables.size();_tables[hashi]._kv = kv;_tables[hashi]._s = EXIST;_n++;return true;}
这其中可能会有人担心swap的效率是不是会拖垮哈希表的效率,其实不会。如果你了解过vector底层的话,它只是会交换底层的指针而已。vector的底层所开辟的空间是由三个指针来维护的。
这是删除和查找。
HashDate<K, V>* find(const K& key){Hash ht;size_t hashi = key % _tables.size();while (_tables[hashi]._s != EMPTY){if (_tables[hashi]._kv.first == key)return &_tables[hashi];hashi++;hashi %= _tables.size();}return nullptr;}bool erase(const K& key){HashDate<K, V>* ret = find(key);if (ret == nullptr) return false;ret->_s = DELETE;return true;}
c. 字符串哈希
我们上面使用直接定址法来让key与数组下标产生联系,但是如果我们的key是字符串的话,我们又该怎么办呢?字符串可不能取模,有人就会说了,我们可以使用ASCII码来解决问题把字符串中的每一个字符相加即可。看似可行,但是如果碰到这种情况呢:aba、aab、baa,这三个字符串可不相同,但是他们的ASCII码之和相同,这就导致存储他们的时候必定会产生错误。所以基于这一情况,先人就已经总结出几种可行的办法:各种字符串Hash函数
这其中我采用BKDRH算法。我们现在可以将字符串存储了,但是如何巧妙的把他加入进去呢?重写一份吗?这肯定是不行的,这不符合我们泛型编程的思想,这个时候仿函数就派上了用场:
template<class K>
struct Hash
{size_t operator()(const K& key){return key;}
};template<>
struct Hash<string>
{size_t operator()(const string& key){int hashi = 0;for (auto c : key){hashi += c;hashi *= 31;}return hashi;}
};
我们对string特化一下,让普通的走普通的仿函数。而对于自定义类型就由用户自己定义Hash函数了,最终效果如下:
enum STATUS
{EMPTY,EXIST,DELETE
};template<class K, class V>
struct HashDate
{pair<K, V> _kv;STATUS _s = EMPTY;
};template<class K>
struct Hash
{size_t operator()(const K& key){return key;}
};template<>
struct Hash<string>
{size_t operator()(const string& key){int hashi = 0;for (auto c : key){hashi += c;hashi *= 31;}return hashi;}
};template<class K, class V, class Hash = Hash<K>>
class HashTables
{
public:HashTables(){_tables.resize(10);}bool insert(const pair<K, V>& kv){if (find(kv.first) != nullptr) return false;if (_n * 10 / _tables.size() >= 7){HashTables<K, V> tmp;tmp._tables.resize(_tables.size() * 2);for (auto& v : _tables){if (v._s == EXIST)tmp.insert(v._kv);}swap(tmp._tables, _tables);}Hash ht;size_t hashi = ht(kv.first) % _tables.size();while (_tables[hashi]._s == EXIST) hashi++, hashi %= _tables.size();_tables[hashi]._kv = kv;_tables[hashi]._s = EXIST;_n++;return true;}HashDate<K, V>* find(const K& key){Hash ht;size_t hashi = ht(key) % _tables.size();while (_tables[hashi]._s != EMPTY){if (_tables[hashi]._kv.first == key)return &_tables[hashi];hashi++;hashi %= _tables.size();}return nullptr;}bool erase(const K& key){HashDate<K, V>* ret = find(key);if (ret == nullptr) return false;ret->_s = DELETE;return true;}private:vector<HashDate<K, V>> _tables;size_t _n = 0;
};
3. 哈希桶
我们前面说了,C++容器中unordered_map底层使用的是哈希桶,我们现在知道了哈希表,那哈希桶又是什么呢?这里我们首先要知道一些小知识:
我们在前面说过哈希表又叫散列表,其实再把它细化一下,它属于闭散列,而我们
的哈希桶则是属于开散列
闭散列:也叫开放定址法,当发生哈希冲突时,如果哈希表未被装满,说明在哈希
表中必然还有空位置,那么可以把key存放到冲突位置中的“下一个” 空位置中去。
开散列:开散列法又叫链地址法(开链法),首先对关键码集合用散列函数计算散列
地址,具有相同地址的关键码归于同一子集合,每一个子集合称为一个桶,各个桶
中的元素通过一个单链表链接起来,各链表的头结点存储在哈希表中。
其实我们读过一遍这个定义之后,就对哈希桶有了一定的了解了,它只不过就是在产生哈希冲突的时候,我们每个键对应的下标都以链表的形式连接起来即可。
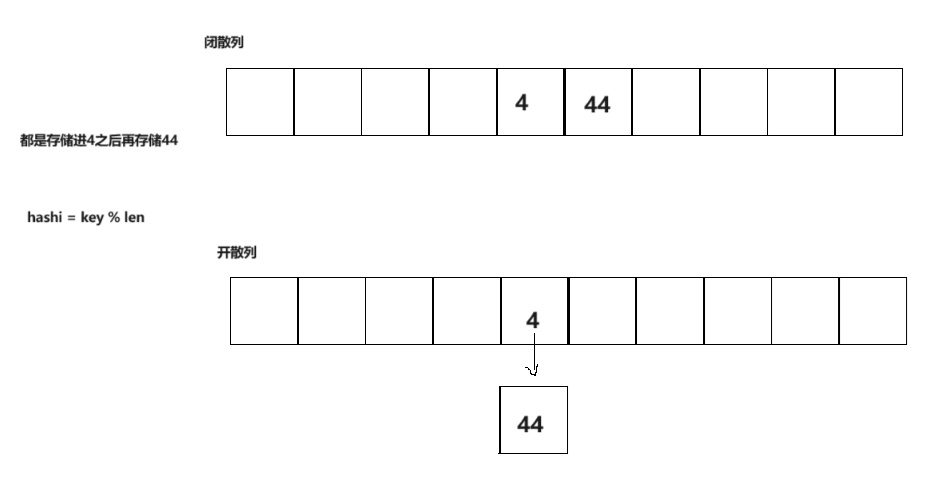
哈希表写完之后,哈希桶也是很简单的:
template<class K, class V>struct HashNode{pair<K, V> _kv;HashNode<K, V>* _next;HashNode(const pair<K, V>& kv):_kv(kv),_next(nullptr){}};template<class K, class V>class HashTables{typedef HashNode<K, V> Node;public:HashTables(){_tables.resize(10, nullptr);}//拷贝构造//赋值~HashTables(){for (int i = 0; i < _tables.size(); i++){Node* cur = _tables[i];while (cur){Node* next = cur->_next;delete cur;cur = next;}}_tables.~vector();}bool insert(const pair<K, V>& kv){if (find(kv.first) != nullptr) return false;if (_n == _tables.size()){vector<Node*> tmp;size_t newsize = _tables.size() * 2;tmp.resize(newsize);for (int i = 0; i < _tables.size(); i++){Node* cur = _tables[i];while (cur){Node* next = cur->_next;size_t hashi = cur->_kv.first % tmp.size();cur->_next = tmp[hashi];tmp[hashi] = cur;cur = next;}扩容之后,析构原有的_tables时内部仍指向节点,所以需要将内部置空//_tables[i] = nullptr;}_tables.swap(tmp);}size_t hashi = kv.first % _tables.size();Node* newnode = new Node(kv);newnode->_next = _tables[hashi];_tables[hashi] = newnode;_n++;return true;}Node* find(const K& key){size_t hashi = key % _tables.size();Node* cur = _tables[hashi];while (cur && cur->_next){if (key == cur->_kv.first)return cur;cur = cur->_next;}return nullptr;}bool erase(const K& key){size_t hashi = key % _tables.size();Node* prenode = _tables[hashi];while (prenode){if (key == prenode->_kv.first){_tables[hashi] = prenode->_next;delete prenode;_n--;return true;}else if (prenode->_next && key == prenode->_next->_kv.first){Node* del = prenode->_next;Node* next = del->_next;prenode->_next = next;delete del;_n--;return true;}prenode = prenode->_next;}return false;}void print(){for (int i = 0; i < _tables.size(); i++){Node* cur = _tables[i];while (cur){cout << cur->_kv.first << ":" << cur->_kv.second << endl;cur = cur->_next;}}cout << _n << endl;cout << endl;}private:vector<Node*> _tables;size_t _n = 0;};
这其中我们发现当我们查找一个元素的时候,如果这个元素正好有着哈希冲突,并且他在链表的最后一个,那岂不是还需要我们遍历链表来寻找他吗?是的,但是我们仍然有着负载因子控制着哈希桶的数组的大小,让哈希桶中存储的数据量一般是等于哈希桶数组的大小时就会扩容,而在扩容的时候,大概率就会将哈希桶中长度很长的链表给拆开重新哈希。所以哈希桶始终保持链表不是太长,而这一特点在现实中也是有着很高的效率,并不会因为链表的遍历而拖垮哈希桶的增删查改。
4.开散列与闭散列比较
应用链地址法处理溢出,需要增设链接指针,似乎增加了存储开销。事实上:
由于开地址法必须保持大量的空闲空间以确保搜索效率,如二次探查法要求装载因子a <= 0.7,而表项所占空间又比指针大的多,所以使用链地址法反而比开地址法节省存储空间。