尚硅谷大数据技术-数据湖Hudi视频教程-笔记01

大数据新风口:Hudi数据湖(尚硅谷&Apache Hudi联合出品)尚硅谷数据湖Hudi视频教程
- B站直达:https://www.bilibili.com/video/BV1ue4y1i7na
- 百度网盘:https://pan.baidu.com/s/1NkPku5Pp-l0gfgoo63hR-Q?pwd=yyds
- 阿里云盘:https://www.aliyundrive.com/s/uMCmjb8nGaC(教程配套资料请从百度网盘下载)
目录
第1章 Hudi概述
001
002
003
004
第2章 编译安装
005
006
007
008
009
第1章 Hudi概述
001
教程详细讲解了Hudi与当前最流行的三大大数据计算引擎:Spark、Flink和Hive的对接过程,内容包括环境准备、多种对接方式、重点配置参数分析、进阶调优手段讲解等,从入门到精通,学习后即可快速投入实际生产使用!
002
hudi
- .parquet:列式存储
- .avro:行式存储
003
1.3 Hudi特性
- 自动管理小文件,数据聚簇,压缩,清理。
004
1.4 使用场景
第2章 编译安装
005
maven修改为阿里镜像
(1)修改setting.xml,指定为阿里仓库地址
vim /opt/module/maven-3.6.1/conf/settings.xml
<!-- 添加阿里云镜像-->
<mirror>
<id>nexus-aliyun</id>
<mirrorOf>central</mirrorOf>
<name>Nexus aliyun</name>
<url>http://maven.aliyun.com/nexus/content/groups/public</url>
</mirror>
006
2.2.3 修改源码兼容hadoop3
007
2.2.4 手动安装Kafka依赖
008
2.2.5 解决spark模块依赖冲突
009
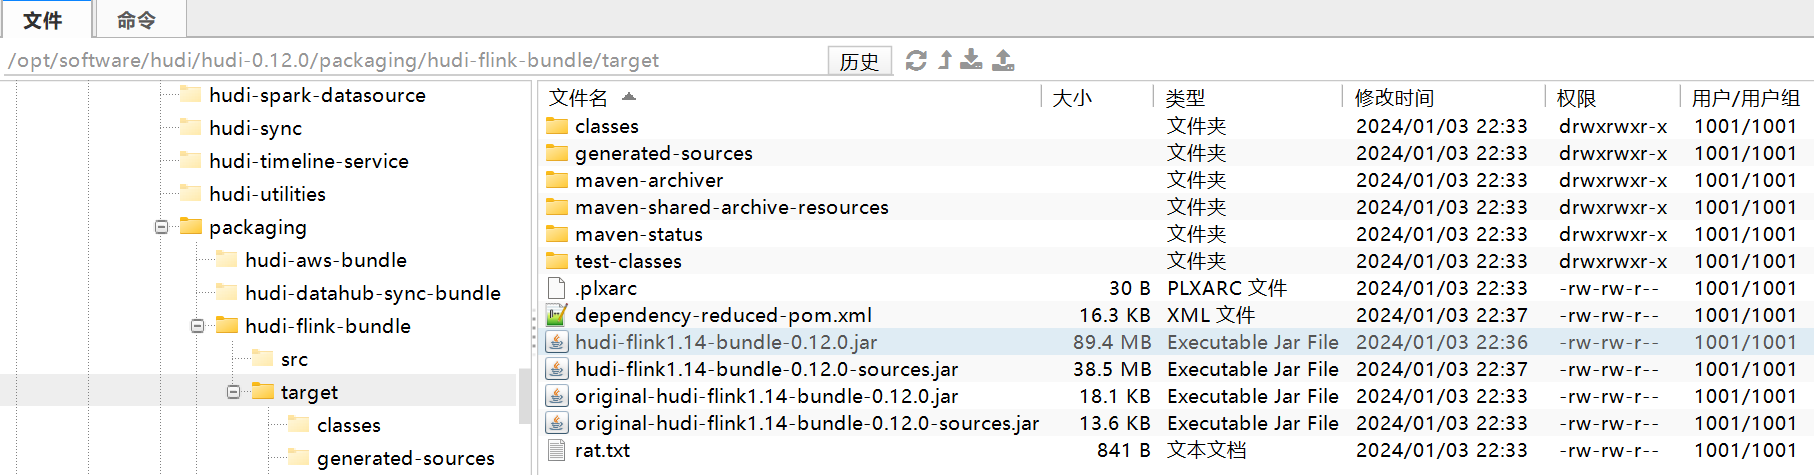
2.2.6 执行编译命令
mvn clean package -DskipTests -Dspark3.2 -Dflink1.13 -Dscala-2.12 -Dhadoop.version=3.1.3 -Pflink-bundle-shade-hive3
[atguigu@node001 hudi-0.12.0]$ mvn clean package -DskipTests -Dspark3.0 -Dflink1.17 -Dscala-2.12 -Dhadoop.version=3.1.3 -Pflink-bundle-shade-hive3