MySQL 索引

1、索引概述
索引是帮助 MySQL 高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用数据,这样就可以在这些数据结构上实现高级查询算法,这种数据结构就是索引。
演示:select * from user where age = 45
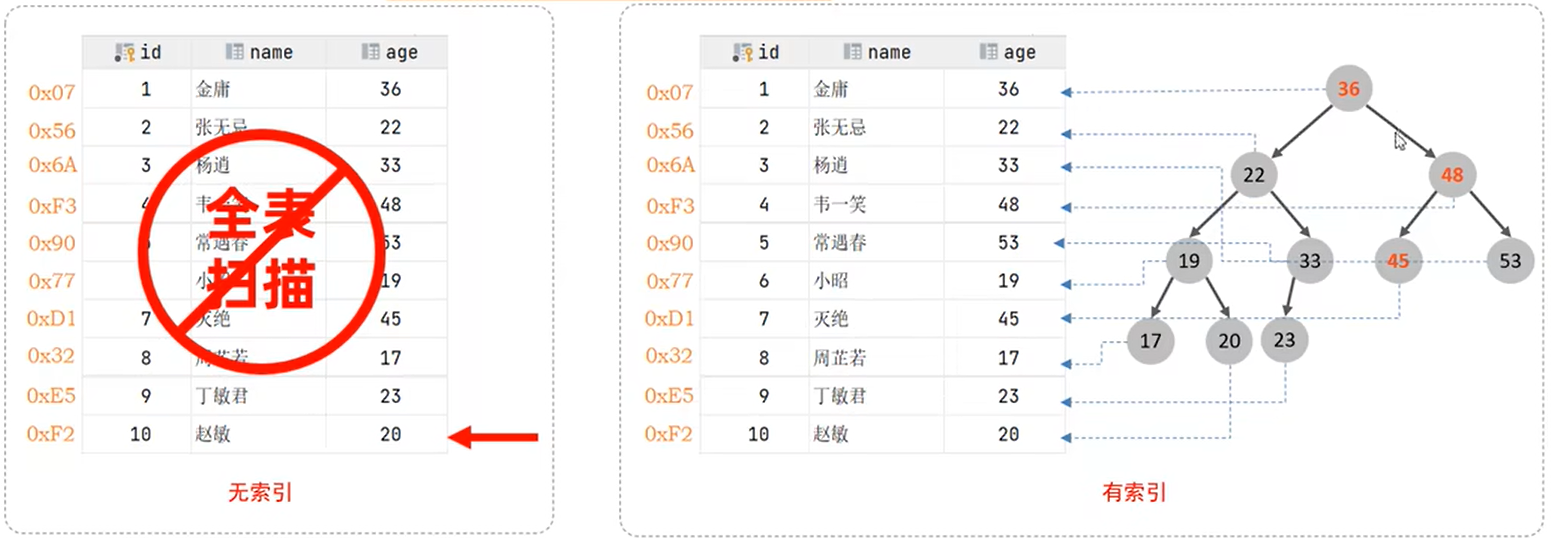
注意:上述二叉树索引结构的只是一个示意图,并不是真实的索引结构。
| 优点 | 缺点 |
| 提高数据检索效率,降低数据库的IO成本 | 索引列也是要占用空间的 |
| 通过索引列对数据进行排序,降低数据排序的成本,降低CPU的消耗 | 索引大大提高了查询效率,但降低了更新的速度,比如 INSERT、UPDATE、DELETE |
2、索引结构
MySQL的索引是在存储引擎层实现的,不同的存储引擎有不同的结构,主要包含以下几种:
| 索引结构 | 描述 |
| B+Tree | 最常见的索引类型,大部分引擎都支持B+树索引 |
| Hash | 底层数据结构是用哈希表实现,只有精确匹配索引列的查询才有效,不支持范围查询 |
| R-Tree(空间索引) | 空间索引是 MyISAM 引擎的一个特殊索引类型,主要用于地理空间数据类型,通常使用较少 |
| Full-Text(全文索引) | 是一种通过建立倒排索引,快速匹配文档的方式,类似于 Lucene, Solr, ES |
| 索引 | InnoDB | MyISAM | Memory |
| B+Tree索引 | 支持 | 支持 | 支持 |
| Hash索引 | 不支持 | 不支持 | 支持 |
| R-Tree索引 | 不支持 | 支持 | 不支持 |
| Full-text索引 | 5.6版本后支持 | 支持 | 不支持 |
a. 二叉树

二叉树缺点∶顺序插入时,会形成一个链表,查询性能大大降低。大数据量情况下,层级较深,检索速度慢。
红黑树可以解决“二叉树顺序插入时形成链表导致查询性能低”的问题
红黑树缺点:大数据量情况下,层级较深,检索速度慢。
b. BTree
多路平衡查找树,以一颗最大度数为5的b-tree为例(每个节点最多存储4个key,5个指针):
- 树的度数:一个节点的子节点个数。
- 每个节点的指针数 = 树的度数
- 每个节点存储的key = 树的度数 - 1


注意:当一个“子节点中的元素个数 = 树的度数时”,此时子节点的中间元素会向上分裂出去。
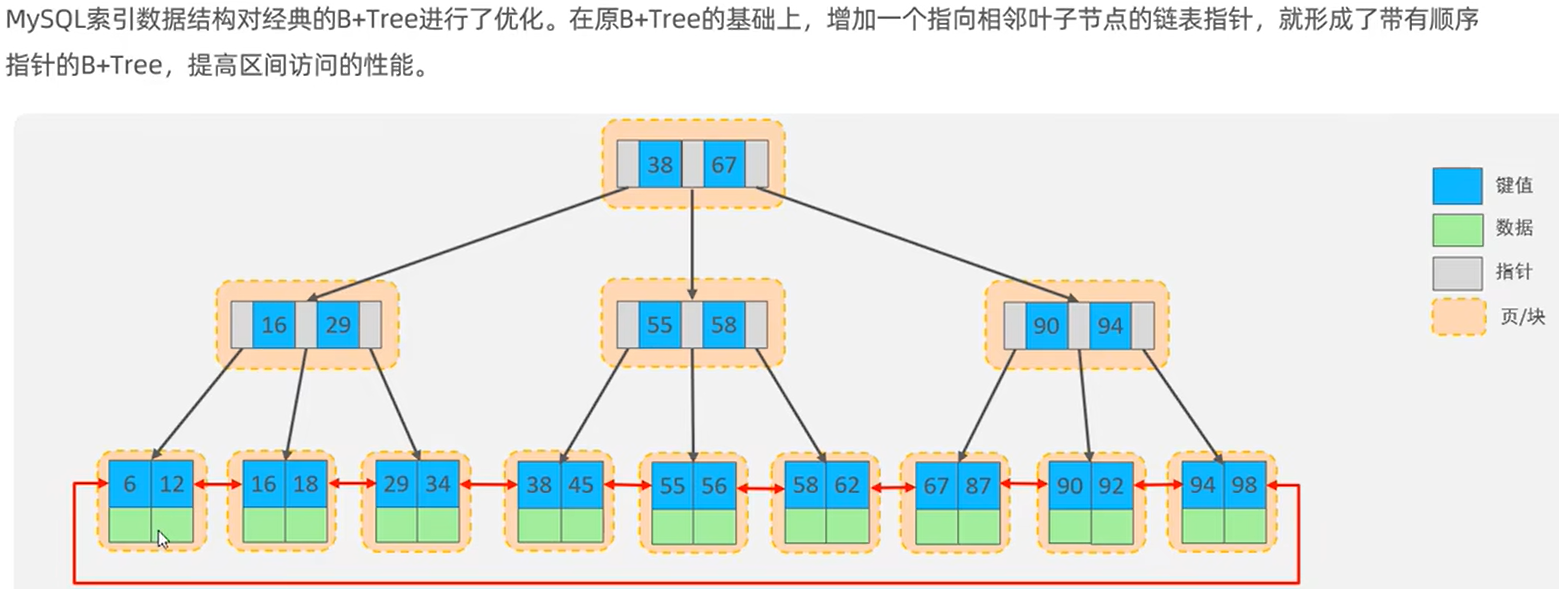
c. B+Tree
以一颗最大度数(max-degree)为4 (4阶)的b+tree为例:
- B+Tree 所有数据都会存在叶子节点,所有叶子节点会形成一个单向链表


注意:当一个“子节点中的元素个数 = 树的度数时”,此时子节点的中间元素会向上分裂且保留在叶子节点一份。
d. Hash
哈希索引就是采用一定的hash算法,将键值换算成新的hash值,映射到对应的槽位上,然后存储在hash表中。如果两个(或多个)键值,映射到一个相同的槽位上,他们就产生了hash冲突(也称为hash碰撞)),可以通过链表来解决。

在MysQL中,支持hash索引的是Memory引擎,而InnoDB中具有自适应hash功能,hash索引是存储引擎根据B+Tree索引在指定条件下自动构建的。
特点:
- 无法利用索引完成排序操作
- Hash索引只能用于对等比较(=、in),不支持范围查询(betwwn、>、<、…)
- 查询效率高,通常只需要一次检索就可以了,效率通常要高于 B+Tree 索引
3、索引分类
| 分类 | 含义 | 特点 | 关键字 |
| 主键索引 | 针对于表中主键创建的索引 | 默认自动创建,只能有一个 | PRIMARY |
| 唯一索引 | 避免同一个表中某数据列中的值重复 | 可以有多个 | UNIQUE |
| 常规索引 | 快速定位特定数据 | 可以有多个 | |
| 全文索引 | 全文索引查找的是文本中的关键词, 而不是比较索引中的值 | 可以有多个 | FULLTEXT |
在 InnoDB 存储引擎中,根据索引的存储形式,又可以分为以下两种:

聚集索引选取规则:
- 如果存在主键,主键索引就是聚集索引。
- 如果不存在主键,将使用第一个唯一(UNIQUE)索引作为聚集索引。
- 如果表没有主键,或没有合适的唯一索引,则InnoDB会自动生成一个rowid作为隐藏的聚集索引。


4、索引语法
- 创建索引:
CREATE [ UNIQUE | FULLTEXT ] INDEX index_name ON table_name (index_col_name, ...); - 查看索引:
SHOW INDEX FROM table_name; - 删除索引:
DROP INDEX index_name ON table_name;
# 准备数据
create table tb_user(id int primary key auto_increment comment '主键',name varchar(50) not null comment '用户名',phone varchar(11) not null comment '手机号',email varchar(100) comment '邮箱',profession varchar(11) comment '专业',age tinyint unsigned comment '年龄',gender char(1) comment '性别 , 1: 男, 2: 女',status char(1) comment '状态',createtime datetime comment '创建时间'
) comment '系统用户表';INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('吕布', '17799990000', 'lvbu666@163.com', '软件工程', 23, '1', '6', '2001-02-02 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('曹操', '17799990001', 'caocao666@qq.com', '通讯工程', 33, '1', '0', '2001-03-05 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('赵云', '17799990002', '17799990@139.com', '英语', 34, '1', '2', '2002-03-02 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('孙悟空', '17799990003', '17799990@sina.com', '工程造价', 54, '1', '0', '2001-07-02 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('花木兰', '17799990004', '19980729@sina.com', '软件工程', 23, '2', '1', '2001-04-22 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('大乔', '17799990005', 'daqiao666@sina.com', '舞蹈', 22, '2', '0', '2001-02-07 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('露娜', '17799990006', 'luna_love@sina.com', '应用数学', 24, '2', '0', '2001-02-08 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('程咬金', '17799990007', 'chengyaojin@163.com', '化工', 38, '1', '5', '2001-05-23 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('项羽', '17799990008', 'xiaoyu666@qq.com', '金属材料', 43, '1', '0', '2001-09-18 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('白起', '17799990009', 'baiqi666@sina.com', '机械工程及其自动化', 27, '1', '2', '2001-08-16 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('韩信', '17799990010', 'hanxin520@163.com', '无机非金属材料工程', 27, '1', '0', '2001-06-12 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('荆轲', '17799990011', 'jingke123@163.com', '会计', 29, '1', '0', '2001-05-11 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('兰陵王', '17799990012', 'lanlinwang666@126.com', '工程造价', 44, '1', '1', '2001-04-09 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('狂铁', '17799990013', 'kuangtie@sina.com', '应用数学', 43, '1', '2', '2001-04-10 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('貂蝉', '17799990014', '84958948374@qq.com', '软件工程', 40, '2', '3', '2001-02-12 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('妲己', '17799990015', '2783238293@qq.com', '软件工程', 31, '2', '0', '2001-01-30 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('芈月', '17799990016', 'xiaomin2001@sina.com', '工业经济', 35, '2', '0', '2000-05-03 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('嬴政', '17799990017', '8839434342@qq.com', '化工', 38, '1', '1', '2001-08-08 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('狄仁杰', '17799990018', 'jujiamlm8166@163.com', '国际贸易', 30, '1', '0', '2007-03-12 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('安琪拉', '17799990019', 'jdodm1h@126.com', '城市规划', 51, '2', '0', '2001-08-15 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('典韦', '17799990020', 'ycaunanjian@163.com', '城市规划', 52, '1', '2', '2000-04-12 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('廉颇', '17799990021', 'lianpo321@126.com', '土木工程', 19, '1', '3', '2002-07-18 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('后羿', '17799990022', 'altycj2000@139.com', '城市园林', 20, '1', '0', '2002-03-10 00:00:00');
INSERT INTO itcast.tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('姜子牙', '17799990023', '37483844@qq.com', '工程造价', 29, '1', '4', '2003-05-26 00:00:00');-- 查看表索引
SHOW INDEX FROM tb_user;
-- name字段为姓名字段,该字段的值可能会重复,为该字段创建索引
create index idx_user_name on tb_user(name);-- phone手机号字段的值非空,且唯一,为该字段创建唯一索引
create unique index idx_user_phone on tb_user (phone);-- 为profession, age, status创建联合索引
create index idx_user_pro_age_stat on tb_user(profession, age, status);-- 为email建立合适的索引来提升查询效率
create index idx_user_email on tb_user(email);-- 删除索引
drop index idx_user_email on tb_user;
5、性能分析
a. SQL 执行频率
查看当前数据库的 INSERT, UPDATE, DELETE, SELECT 访问频次:
-- 查看全局的访问频次
SHOW GLOBAL STATUS LIKE 'Com_______'; -- 查看当前会话的访问频次
SHOW SESSION STATUS LIKE 'Com_______';
b. 慢查询日志
慢查询日志记录了所有执行时间超过指定参数(long_query_time,单位:秒,默认10秒)的所有SQL语句的日志。
查看慢查询日志开关状态:show variables like 'slow_query_log';
MySQL的慢查询日志默认没有开启,需要在MySQL的配置文件(/etc/my.cnf)中配置如下信息:
# 开启慢查询日志开关
slow_query_log=1
# 设置慢查询日志的时间为2秒,SQL语句执行时间超过2秒,就会视为慢查询,记录慢查询日志
long_query_time=2
更改后记得重启MySQL服务,日志文件位置:/var/lib/mysql/localhost-slow.log
c. profile
show profile 能在做SQL优化时帮我们了解时间都耗费在哪里。通过 have_profiling 参数,能看到当前 MySQL 是否支持 profile 操作:SELECT @@have_profiling;
-- 查看profiling是否开启
select @@profiling;-- profiling 默认关闭,可以通过set语句在session/global级别开启 profiling:
SET profiling = 1;-- 查看所有语句的耗时
show profiles;
-- 查看指定query_id的SQL语句各个阶段的耗时:
show profile for query query_id;
--查看指定query_id的SQL语句CPU的使用情况
show profile cpu for query query_id;
d. explain
EXPLAIN 或者 DESC 命令获取 MySQL 如何执行 SELECT 语句的信息,包括在 SELECT 语句执行过程中表如何连接和连接的顺序。
# 直接在select语句之前加上关键字 explain / desc
EXPLAIN | DESC SELECT 字段列表 FROM 表名 HWERE 条件;explain select * from tb_user;
① id,select 查询的序列号:表示查询中执行 select 子句或者操作表的顺序。(如果id相同,执行顺序从上到下;id不同,值越大越先执行)


② select_type,表示 SELECT 的类型:常见取值有 SIMPLE(简单表,即不适用表连接或者子查询)、PRIMARY(主查询,即外层的查询)、UNION(UNION中的第二个或者后面的查询语句)、SUBQUERY(SELECT/WHERE之后包含了子查询)
③ type,表示连接类型:性能由好到差的连接类型为 NULL、system、const、eq_ref、ref、range、index、all
④ possible_key 可能应用在这张表上的索引,一个或多个
⑤ Key,实际使用的索引:如果为 NULL,则没有使用索引
⑥ Key_len,表示索引中使用的字节数:该值为索引字段最大可能长度,并非实际使用长度,在不损失精确性的前提下,长度越短越好。
⑦ rows MySQL认为必须要执行的行数,在InnoDB引擎的表中,是一个估计值,可能并不总是准确的
⑧ filtered 表示返回结果的行数占需读取行数的百分比,filtered的值越大越好
6、索引使用
a. 最左前缀法则
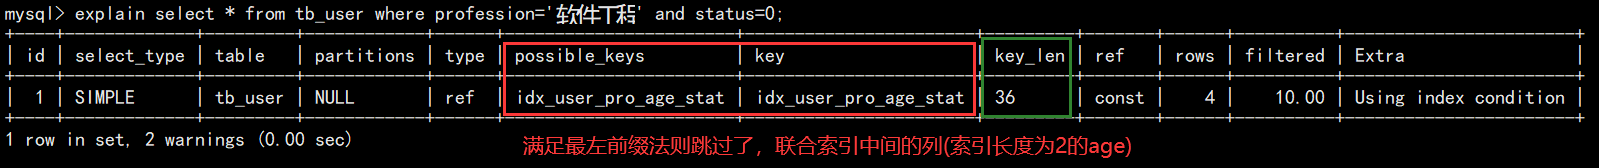
使用联合索引要遵守“最左前缀法则”:查询时包含“联合索引的最左列”(和查询时的位置无关 ),并且不跳过索引中的列。如果跳跃某一列,索引将部分失效(后面的字段索引失效)。
# 查看tb_user表中的联合索引
show index from tb_user;


b. 范围查询
联合索引中,出现范围查询(<, >),范围查询右侧的列索引失效。可以用>=或者<=来规避索引失效问题。

c. 索引失效情况

① 在索引列上进行运算操作,索引将失效。

② 字符串类型字段使用时,不加引号,索引将失效。

③ 模糊查询中,仅仅是尾部模糊匹配,索引不会是失效;如果是头部模糊匹配,索引失效。前后都有 % 也会失效。

④ 用 or 分割开的条件,如果 or 其中一个条件的列没有索引,那么涉及的索引都不会被用到。

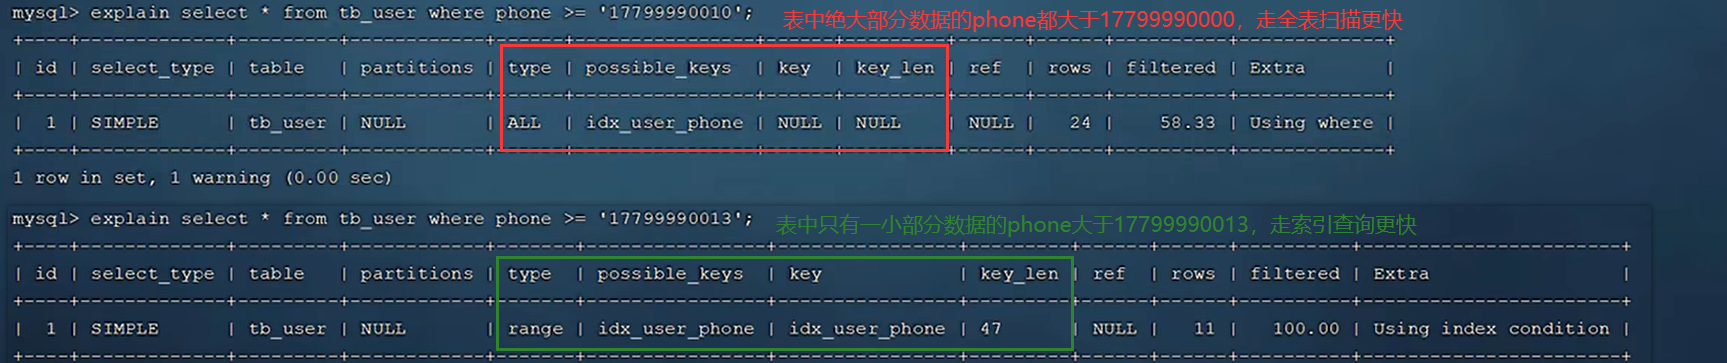
⑤ 如果 MySQL 评估使用索引比全表更慢,则不使用索引。
d. SQL 提示
数据库的某些字段,可能同时存在多个索引,默认查询该字段时,MySQL自动选择使用的索引,使用“SQL提示”加入一些人为的提示来达到优化操作的目的。
| 索引提示 | 描述 |
|
| 建议使用哪个索引,实际使用哪个索引 MySQL 还会自己权衡运行速度去更改 |
|
| 不使用哪个索引 |
|
| 必须使用的索引,无论如何都强制使用该索引。 |


e. 覆盖索引
尽量使用覆盖,减少 使用select *,因为很容易出现回表查询的情况(除非建立一个包含所有字段的联合索引)。


explain 中 extra 字段含义:
using index condition: 查找使用了索引,但是需要回表查询数据using where;using index:查找使用了索引,但是需要的数据都在索引列中能找到,所以不需要回表查询
面试题:一张表,有四个字段(id, username, password, status),由于数据量大,需要对以下SQL语句进行优化,该如何进行才是最优方案:select id, username, password from tb_user where username='itcast';
解:给username和password字段建立联合索引,则不需要回表查询,直接覆盖索引
f. 前缀索引
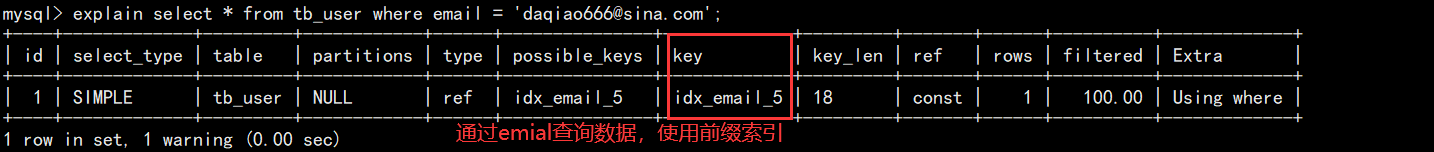
描述:当字段类型为字符串(varchar, text等)时,有时候需要索引很长的字符串,这会让索引变得很大,浪费大量的磁盘IO,影响查询效率,此时可以只将字符串的一部分前缀,建立索引,这样可以大大节约索引空间,从而提高索引效率。
语法:create index idx_xxxx on table_name(columnn(n));
前缀长度:可以根据索引的选择性来决定,而选择性是指不重复的索引值(基数)和数据表的记录总数的比值,索引选择性越高则查询效率越高,唯一索引的选择性是1,这是最好的索引选择性,性能也是最好的。求选择性公式:
select count(distinct email) / count(*) from tb_user;
select count(distinct substring(email, 1, 5)) / count(*) from tb_user;

7、设计原则
① 针对于数据量较大,且查询比较频繁的表建立索引。
② 针对于常作为查询条件(where)、排序(order by)、分组(group by)操作的字段建立索引。
③ 尽量选择区分度高的列作为索引,尽量建立唯一索引,区分度越高,使用索引的效率越高。
④ 如果是字符串类型的字段,字段长度较长,可以针对于字段的特点,建立前缀索引
⑤ 尽量使用联合索引,减少单列索引,联合索引很多时候可以覆盖索引,节省存储空间,避免回表,提高查询效率
⑥ 要控制索引的数量,索引并不是多多益善,索引越多,维护索引结构的代价就越大,会影响增删改的效率
⑦ 如果索引列不能存储NULL值,请在创建表时使用NOT NULL约束它。当优化器知道每列是否包含NULL值时,它可以更好地确定哪个索引最有效地用于查询